Construir um protótipo de chatbot financeiro em 4 semanas
Quando um dos nossos parceiros nos desafiou a explorar a IA num contexto financeiro real, o objetivo foi claro: construir, em tempo recorde (4 semanas!), um chatbot capaz de dar respostas úteis sobre consolidação de crédito.
Na CRON STUDIO, abordamos o desafio com a nossa mentalidade habitual de criação de startups, começando com a filosofia do Produto Mínimo Viável (MVP). Em vez de procurarmos a complexidade ou a completude desde o primeiro dia, focamo-nos em entregar uma solução simples, útil e mensurável. Isto permitiu-nos validar as principais premissas desde o início, entregar valor tangível e deixar espaço para iterações mais inteligentes no futuro.
O que significa na prática? Com este protótipo, um utilizador pode ter uma conversa natural, com cálculos precisos, onde:
- Questão “Posso consolidar o meu crédito habitação com o financiamento do meu automóvel?” e recebe uma estimativa instantânea do novo valor da prestação mensal e da poupança potencial.
- Diz “Quanto pagaria se reduzisse o prazo de 30 para 20 anos?” e vê um recálculo claro no momento, sem possibilidade de ilusões.
- Solicita “Como posso avançar com esta oferta?” e é redirecionado para um consultor de crédito específico que pode ajudar a fechar o negócio.
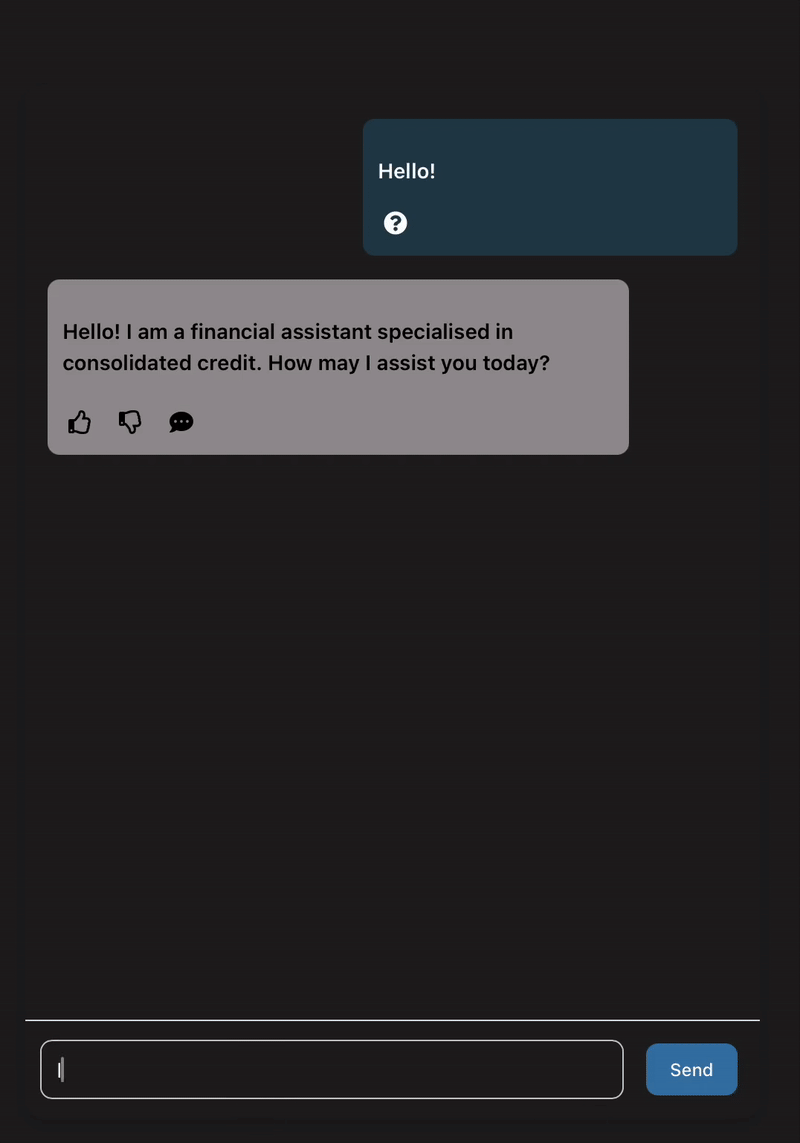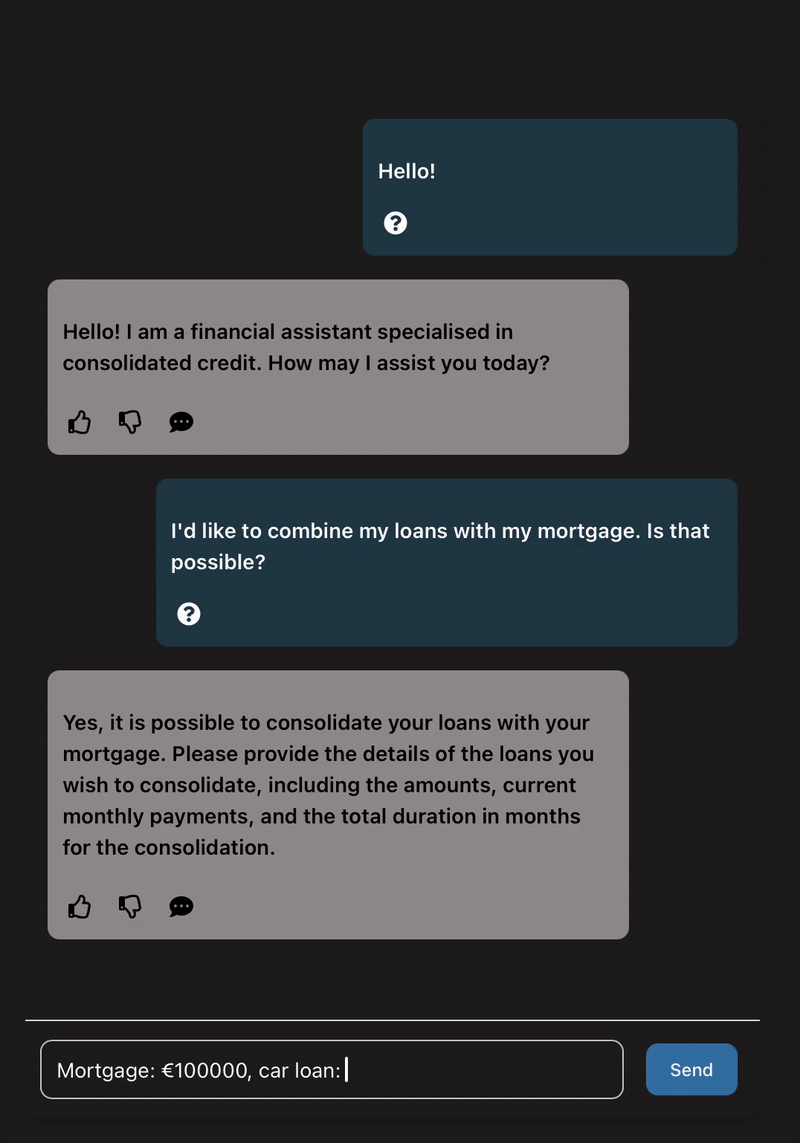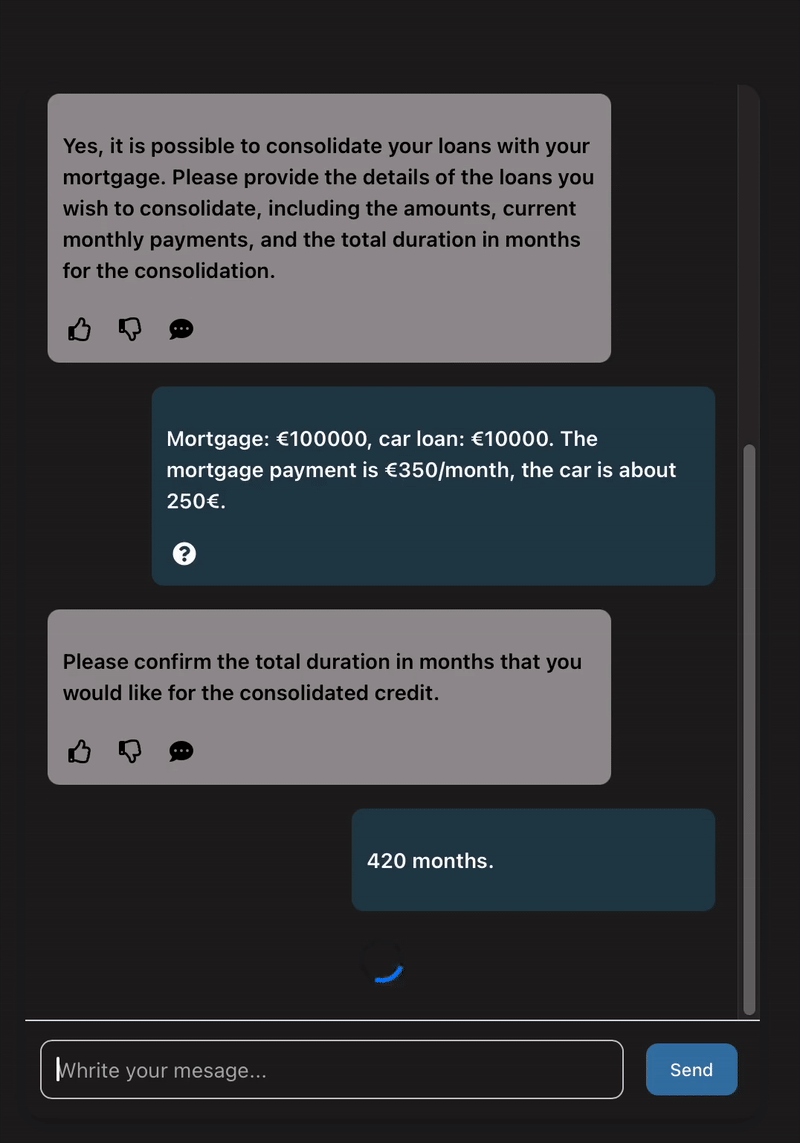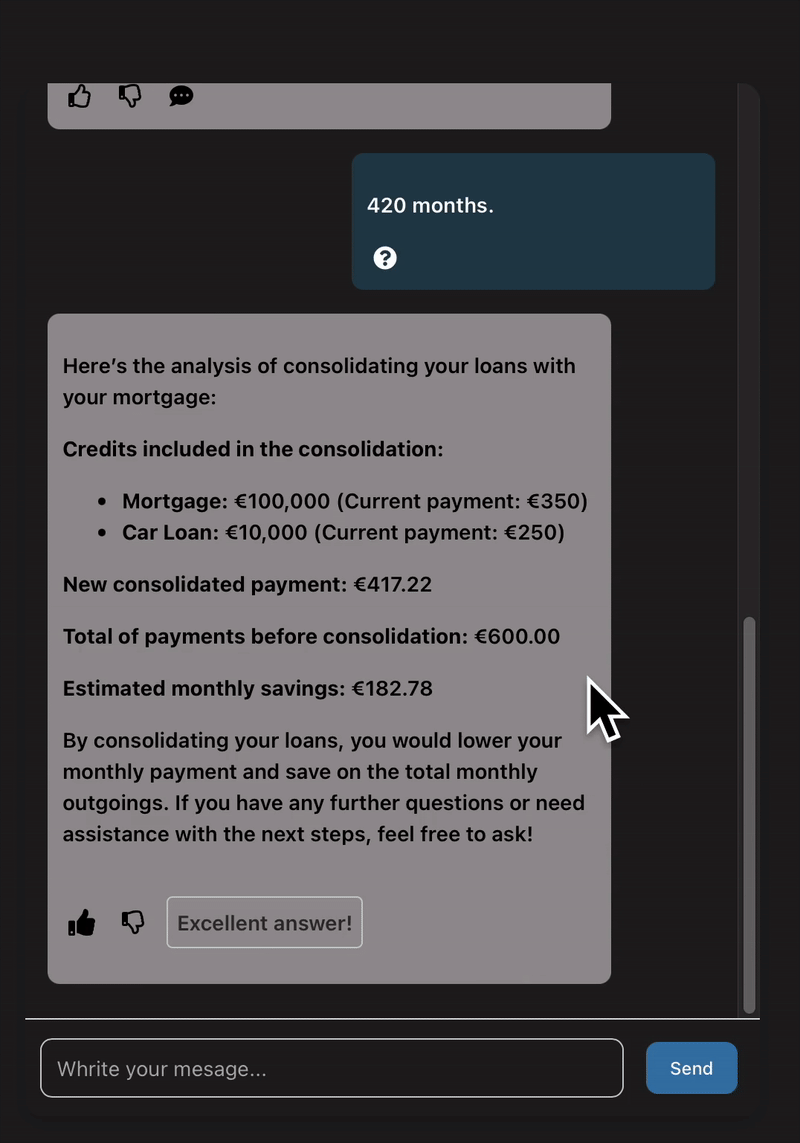
Neste post de blog, queremos partilhar como construímos este protótipo e algumas das nossas principais conclusões, para que possa ter uma ideia de como trabalhamos ou para que possa tentar construir os seus próprios protótipos. 🙂
Construir um Protótipo Funcional em Um Mês
A arquitetura foi concebida para clareza e velocidade. Utilizamos o Django para estruturar e expor a lógica de negócio através de uma API limpa, mantendo as responsabilidades do lado do servidor previsíveis e fáceis de evoluir. No frontend, o React forneceu uma interface leve focada exclusivamente na experiência do utilizador.
A lógica do chatbot foi concebida para ser o mais simples e previsível possível: o LLM interpretava a intenção do utilizador, enquanto o nosso backend retornava resultados com base em cálculos financeiros reais e registava cada par mensagem-resposta para rastreabilidade e melhoria. Isto tornou o sistema fácil de testar e iterar, ao mesmo tempo que estabelecia as bases para um comportamento mais inteligente e com estado no futuro.
Desenhar uma Experiência Conversacional que Parece Natural
Ao conceber a experiência do chatbot, tivemos de encontrar um equilíbrio entre controlo e flexibilidade. Enquanto alguns chatbots são totalmente guiados e outros completamente abertos, procurámos algo intermédio: um sistema onde a entrada do utilizador pudesse desencadear cálculos precisos, mas o assistente ainda soasse natural e prestável.
Para tal, decidimos utilizar a chamada de função da OpenAI. Permitiu-nos inserir precisão na conversa sem sacrificar um tom natural. Por exemplo, quando um utilizador pergunta: "Posso consolidar todos os meus empréstimos?", o LLM compreende a intenção e, assim que obtém as informações necessárias, desencadeia uma simulação de backend personalizada para o caso do utilizador, sem interromper o fluxo da conversa.
Inicialmente, explorámos a ideia de encaminhar perguntas comuns através de uma camada de classificação leve, que associa entradas frequentes a respostas predefinidas. Chegámos a considerar pesquisas de similaridade baseadas em embeddings. Mas, em prol da velocidade e da clareza, optámos por deixar o LLM lidar com a maioria dos pedidos, utilizando a chamada de função da OpenAI para cobrir os nossos principais casos de utilização com precisão.
Ainda assim, lançamos as bases para algo mais poderoso: cada mensagem do utilizador é registada e pode ser etiquetada com a sua intenção, criando um conjunto de dados para um encaminhamento mais inteligente no futuro. Isto significa que o chatbot poderá, um dia, responder ainda mais rapidamente e a um custo mais baixo, sem comprometer a clareza ou a experiência.
Dizer Não Faz Parte de Construir Bem
Quando se constrói algo em apenas quatro semanas, escolher o que não fazer é tão importante como decidir o que incluir. Sabíamos desde o início que a tentação de exagerar na engenharia, adicionar funcionalidades em tempo real, construir modelos de utilizador avançados ou ajustar um LLM só nos iria atrasar.
Considerámos várias opções que, embora interessantes, não faziam sentido nesta fase. Por exemplo:
- Os WebSockets eram desnecessários para um modelo de interação pedido-resposta.
- A pesquisa baseada na incorporação acrescentava complexidade sem um benefício claro a curto prazo.
- O ajuste fino do LLM não era viável sem um conjunto robusto de exemplos selecionados.
O que rejeitámos foi tão deliberado como o que construímos. Permitiu-nos focar na entrega de algo concreto e deixou a porta aberta para atualizações mais inteligentes no futuro.
Testes Internos e Ciclos de Feedback
Em vez de esperar por uma versão finalizada para obter feedback, demos aos primeiros testadores as ferramentas para moldar o chatbot em tempo real. Ao permitir que cada mensagem fosse avaliada e comentada, abrimos uma linha direta entre os utilizadores e o comportamento central do produto.
Isto não foi apenas útil, foi transformador. Com estes dados, conseguimos gerar relatórios de feedback, ajustar as mensagens do sistema, adicionar ou remover comportamentos e detetar desalinhamentos precocemente. Descobrimos que algumas coisas que o chatbot podia fazer não eram coisas que ele devesse fazer, e não teríamos percebido isso sem este mecanismo.
O que começou como um simples mecanismo de avaliação acabou por se tornar uma das partes mais valiosas do desenvolvimento. Manteve-nos focados em casos de utilização reais e deu-nos confiança na direção do produto final.
Restrições Reais, Desafios Reais
Trabalhar com dados financeiros significava ser preciso tanto tecnicamente como na linguagem. Tínhamos de representar as condições de empréstimo, simular cenários de consolidação e responder a questões complexas dos utilizadores, tudo isto sem induzir em erros ou simplificar em demasia. Isto exigiu um alinhamento cuidadoso entre a linguagem da interface, a lógica do sistema e as instruções do modelo.
Também tivemos de lidar com a incerteza técnica. Mesmo com ferramentas como a chamada de funções da OpenAI, as respostas podem variar consoante a forma como o modelo interpreta o contexto. Garantir a repetibilidade entre conversas significava iterar no design das instruções, na formatação dos pedidos e no tratamento de casos extremos.
Escolher o modelo certo fez parte do desafio. Como se tratava de um MVP (Minimal Viable Product), demos prioridade a um equilíbrio entre desempenho, custo e garantia de compatibilidade futura. Selecionámos uma variante do GPT-4o mini, o modelo pequeno e económico da OpenAI, que apresentou ótimos resultados em chamadas de funções, raciocínio e suporte multilingue, tudo a uma fração do custo dos modelos maiores. A lição? A seleção do modelo não se resume apenas à capacidade: trata-se de tempo, custo-benefício e alinhamento com a maturidade do produto. O GPT-4o mini forneceu-nos o que precisávamos: inteligência fiável, respostas rápidas e a flexibilidade para futuras atualizações.
Principais lições para projetos futuros
O valor não vem da complexidade, mas da solução simples dos problemas certos. Este projeto relembrou-nos que os melhores protótipos não só demonstram funcionalidades, como comprovam a sua utilidade.
- Comece com restrições, não com funcionalidades: em vez de perguntar "o que podemos construir?", perguntamos "o que é que isto precisa de resolver e sob que limites?". Isto mudou a mentalidade da ideação aberta para a resolução focada de problemas. Os limites que definimos desde o início pouparam tempo, reduziram a ambiguidade e ajudaram a alinhar todos em torno do que era mais importante.
- Estabilize a experiência principal antes de expandir: é tentador adicionar funcionalidades, melhorar casos extremos ou integrar novas APIs. Mas damos prioridade a acertar numa coisa: uma experiência de chat fluida, útil e fiável. Só depois de esta base estar sólida é que outras adições fariam sentido, e esta disciplina se revelaria eficaz em termos de clareza e coerência.
- Diga não às distrações: evitamos deliberadamente a complexidade prematura: nada de LLMs (Modelos de Aprendizagem Baseados em Lógica) refinados, nada de motores de busca integrados, nada de infraestrutura em tempo real. Estas ideias não foram descartadas para sempre, apenas adiadas até que a necessidade e o momento fossem adequados. Isto manteve o sistema enxuto e de fácil manutenção, ao mesmo tempo que permitiu espaço para a evolução.
- Trate a IA como infraestrutura, não como magia: percebemos desde o início que a chamada de funções era essencial para os nossos casos de utilização. Não podíamos confiar que o modelo adivinhasse tudo, por isso moldámos a experiência com estrutura, orientação e lógica de contingência.
- Incorpore o feedback no sistema: o feedback da experiência do utilizador não era apenas um "diferencial" – era parte integrante do produto. Permitir que os testadores avaliassem as respostas e deixassem comentários criou um ciclo que utilizámos para melhorar ativamente o comportamento, as mensagens e até o design dos avisos.
- Pense na modularidade desde o primeiro dia: mesmo num protótipo, procurámos componentes que pudessem ser reutilizados, substituídos ou escalados. Isto aplicava-se à lógica de backend. Não abstraímos demasiado, mas deixamos espaço para versões mais inteligentes no futuro. Isto é mais fácil dizer do que fazer – mas, por outro lado, é por isso que nos consideramos grandes engenheiros.
Resultados e Próximos Passos
Em apenas quatro semanas, entregámos um protótipo totalmente funcional que cumpria os requisitos principais: os utilizadores podiam fazer perguntas naturais sobre a consolidação de crédito e receber respostas personalizadas, matematicamente precisas e baseadas em dados, tudo dentro de uma interface limpa e intuitiva.
Consideramos o projeto um sucesso, não por ser impecável, mas por funcionar onde mais importava. Os utilizadores receberam respostas relevantes, as interações pareceram naturais e o sistema subjacente revelou-se estável e adaptável. O feedback inicial sugeriu que o assistente já era útil e intuitivo, não perfeito, mas promissor.
Mais importante ainda, a base que construímos foi sólida: um sistema modular, um conjunto de dados crescente de interações reais e uma noção clara de para onde ir a seguir. Para o nosso parceiro, este não é apenas um protótipo, é um trampolim fiável para iterações futuras, integrações mais profundas e uma automatização mais inteligente.
Provámos que um assistente com tecnologia LLM pode oferecer orientação relevante sobre um tema tão sensível e complexo como as finanças pessoais. E fizemo-lo sem promessas exageradas, complicação excessiva ou perder de vista o que os utilizadores realmente precisam: respostas claras, honestas e úteis.
Próximo passo? A versão 2.0 — em breve.
Artigo escrito por Tiago Caniceiro.
Quer saber mais sobre como criamos soluções de IA que fazem a diferença? Fale connosco!